问题不是分析一条 JD,而是重复完成整套求职判断
每看到一个新岗位,我都要重新判断匹配度、调整简历、准备面试,并在散落的项目材料里寻找可以支持回答的事实。
每遇到一个新岗位,都要重复完成。
每遇到一个新岗位,都要重复完成。
每遇到一个新岗位,都要重复完成。
每遇到一个新岗位,都要重复完成。
最初的需求看起来只是“让 AI 分析一个 JD”,真实使用后才发现,真正的问题是一整套判断与资料调用无法持续积累。
先收紧产品边界,再决定 AI 应该做什么
- 岗位分析与简历建议
- 面试 Project Grounding
- Jobs 记录与持续管理
AI 求职工作台
模型不补充不存在的个人经历
- 招聘平台与自动投递
- 账号系统与云端数据库
- 通用 SaaS 与功能堆叠
V1 不追求功能数量,也不把所有流程塞进一个聊天框。产品需要让用户理解当前任务、看到判断依据,并能够在后续求职流程中继续调用结果。
三条职责清晰的工作流,而不是一个万能输入框
岗位评分、面试准备和投递管理使用不同材料,也承担不同任务。
边界:Projects 补充面试语境,但不参与岗位匹配评分。
从 JD 与 Resume 得到可追溯的岗位分析
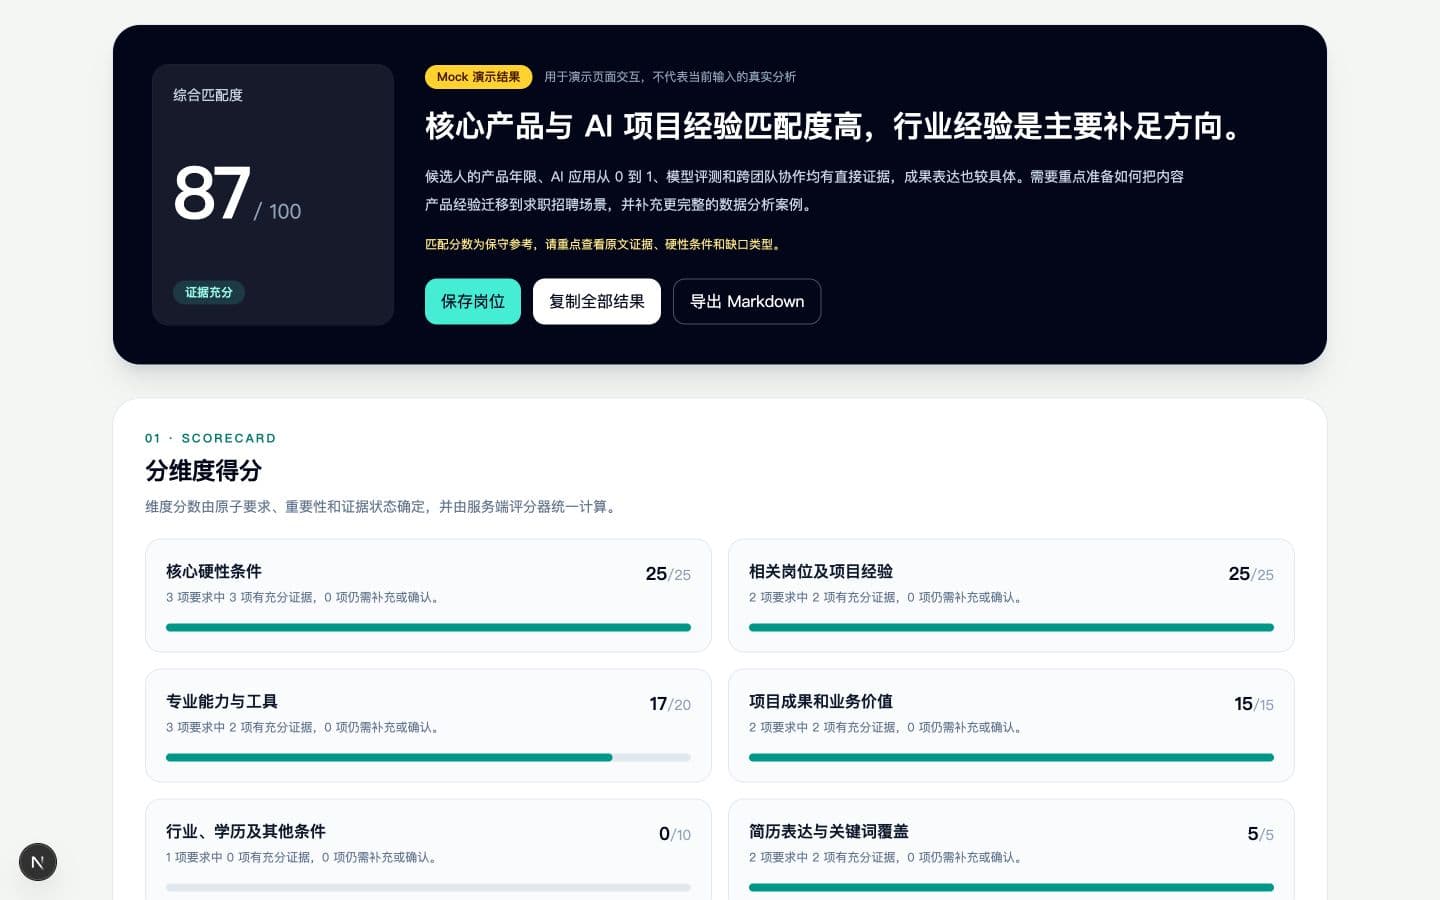
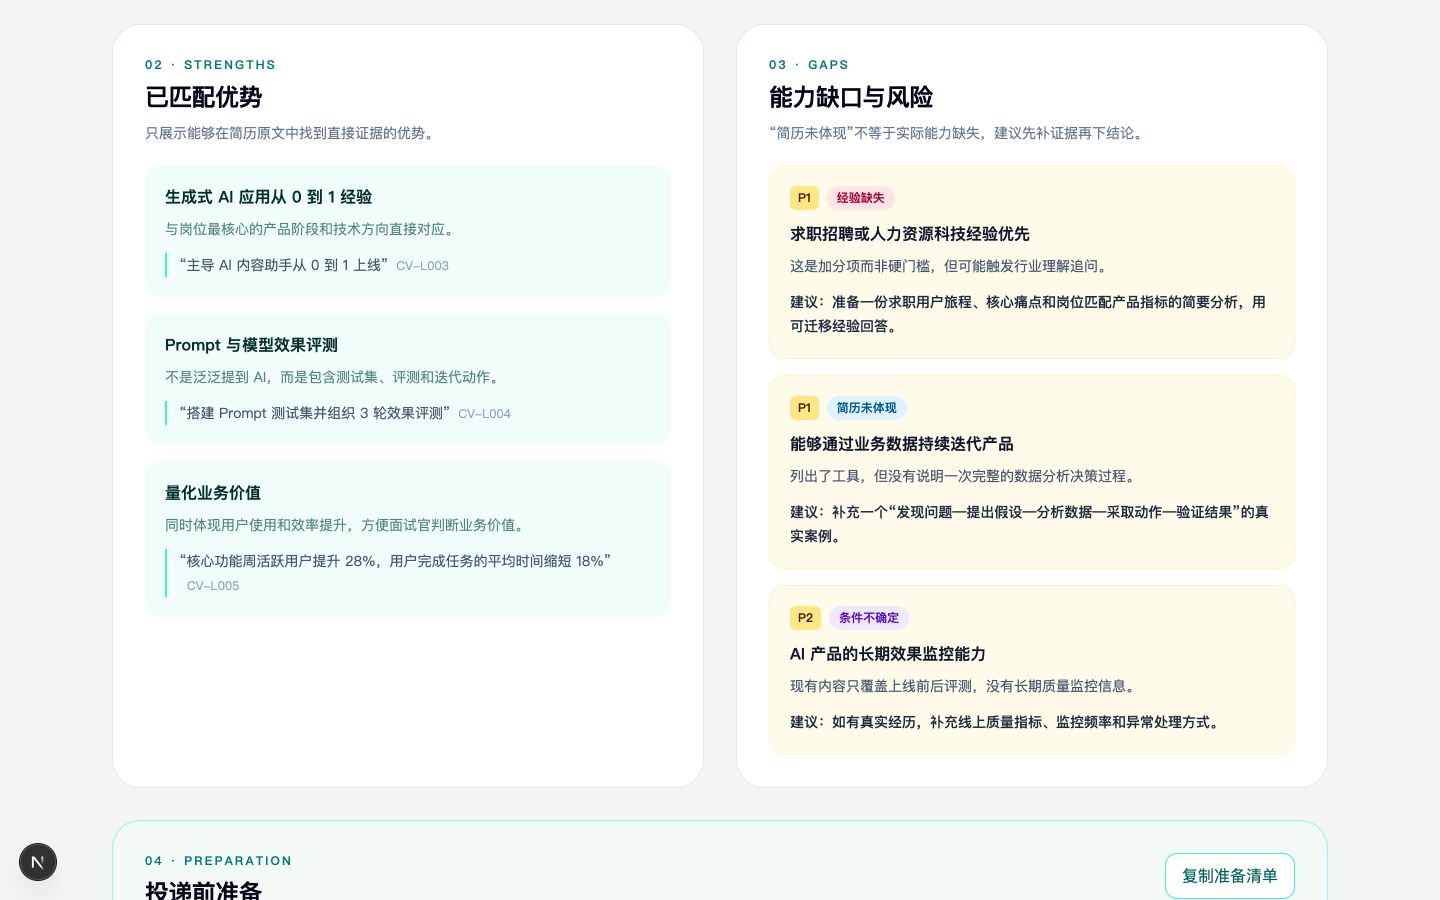
匹配评分只基于 JD 与 Resume;分析结果继续承接简历建议与投递前准备。
关键设计围绕可信、稳定与持续使用展开
让 AI 输出 Grounded
求职建议必须能够追溯到 JD、简历或用户选择的项目事实。模型只返回 Evidence ID,原文由服务端恢复,避免为了完整回答而补充不存在的经历。
评分与生成解耦
匹配度不能完全交给模型自由判断。结构化要求、Evidence 校验和整数评分保持确定性;模型负责在事实边界内生成解释与建议。
稳定、可追溯、可重复检查
在已验证事实边界内组织表达
从单次报告变成持续工作台
当分析结果需要在简历修改、面试准备和投递跟进中被反复调用,Jobs 与 Projects 就不再是附加功能,而是改变产品定位的核心结构。
Local-first
Resume、JD 和项目经历具有隐私敏感性。V1 选择本地保存,避免过早引入账号、云端数据库和额外隐私风险,优先验证产品链路是否成立。
保存在用户本地
减少账号与云端依赖,优先验证核心链路,同时接受跨设备同步缺失。
改变产品的原因,比新增功能更重要
先验证一次分析
问题:岗位判断反复从头开始。
判断:先验证 JD 与 Resume 能否形成可读结论。
先让结果稳定可信
问题:自由生成的结构与评分会波动。
判断:固定输出结构,并加入评分校验与 Evidence。
承接分析后的动作
问题:报告之后仍要重复准备简历和面试。
判断:拆分 Advice,并让 Projects 专门服务 Grounding。
沉淀为持续工作台
问题:历史结果与投递状态无法积累。
判断:加入 Jobs,并重组为清晰的求职工作区。
当前验证的是产品链路与可信输出,不是 PMF
核心链路能够成立
- 最新 5 组脱敏基线 5/5 完成端到端流程
- Evidence 能够追溯到输入材料
- 分析结果可继续承接面试准备与岗位管理
评分理解与真实用户价值
- 当前匹配评分偏保守
- 预期分数区间通过率仍不足
- 不同背景用户是否理解评分并信任 Evidence
- 产品是否真正减少重复修改简历的工作
Technical Evaluation
详细性能、重试和工程指标保留在项目测试资料中,不作为 Case Study 的主结果。
继续开发,应该以新的真实问题为条件
下一阶段不由功能清单驱动。只有下面的条件在真实使用中出现,新增复杂度才有意义。
相同的重复求职问题在不同背景用户中持续出现。
用户能够理解评分、追溯 Evidence,并观察到实际时间节省。
账号、协作或云端能力确实能解决已验证的使用阻力。